Commencez par la cible d'entraînement.
Avant de choisir une méthode de capture, écrivez la sortie que votre modèle doit prédire. Un modèle qui identifie l'étape suivante de la tâche a besoin d'une cible différente d'un contrôleur qui prédit une commande conjointe à chaque étape. Plus de démonstrations n'est pas assez spécifique pour faire ce choix.
Comment les deux méthodes se comparent.
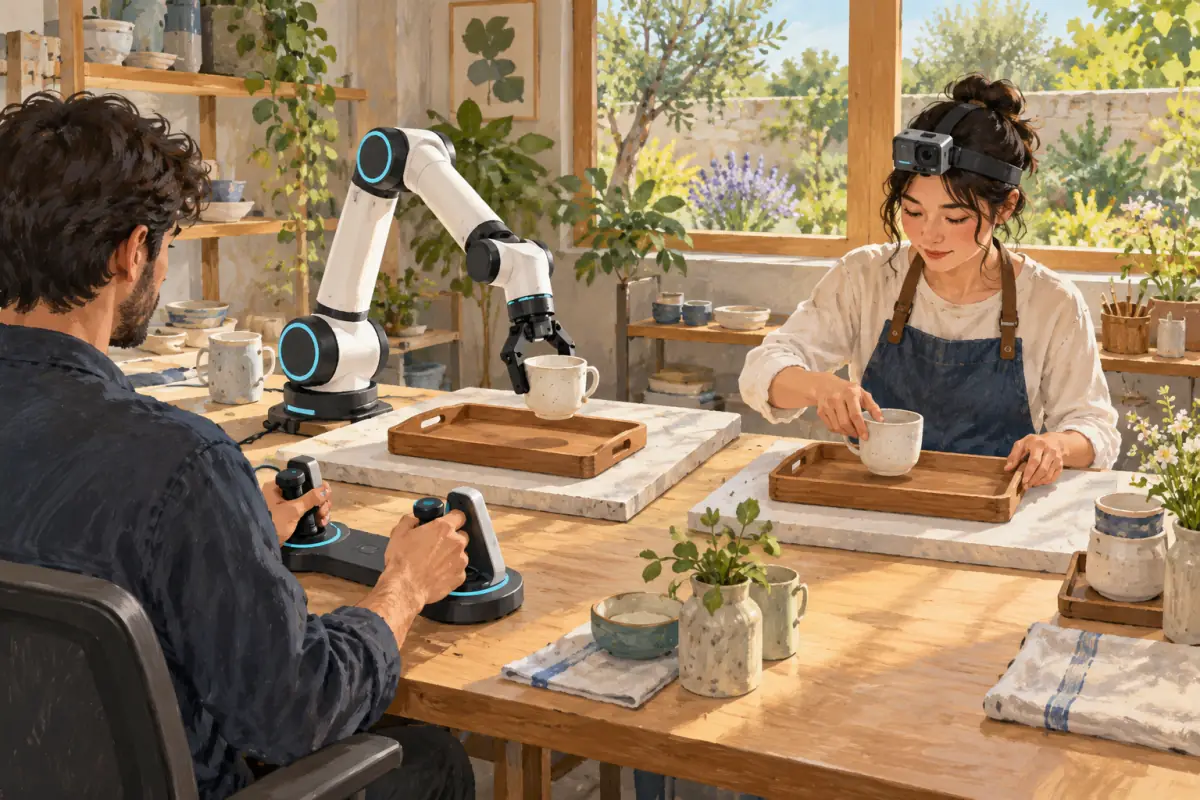
| Question | Données relatives à la téléopération | Vidéo humaine égocentrique |
|---|---|---|
| Qui effectue la tâche physique? | Le robot, sous contrôle humain. | La personne qui porte la caméra. |
| Que peut-on observer? | Les vues des caméras robot et les capteurs sont enregistrés. | La personne a une vue sur les mains, les outils et les environs. |
| D'où viennent les actions ? | Commandes enregistrées, avec leur signification documentée. | Pas de commandes de robot natif dans la seule vidéo. |
| Qu'est-ce qui limite la collecte? | Disponibilité du robot, espace de travail, interface opérateur et réinitialisation du temps. | Accès aux tâches, visibilité de la caméra, autorisations et qualité d'enregistrement. |
| Qu'est-ce qui doit être transféré ? | Dans l'ensemble des configurations de robots d'entraînement et de déploiement. | De l'observation humaine au robot, la détection et l'incarnation. |
La synchronisation fait partie de la démonstration.
Pour un robot cible d'action, distinguer quand une image a été exposée, quand une commande a été émise et quand le robot a bougé. Un numéro de ligne ne prouve pas que ces événements se sont produits ensemble. Les décalages d'horloge, les cadres abandonnés et latence peuvent changer la relation que le modèle apprend.
La vidéo humaine peut préserver le contexte qui compte.
Un travailleur peut marcher jusqu'à une étagère, choisir un outil, nettoyer un espace, accomplir une tâche et ranger l'équipement. Cette séquence plus large peut aider une équipe à étudier la structure des tâches ou le contexte visuel. Cela ne signifie pas que le même enregistrement enseigne directement à un robot à exécuter chaque mouvement.
Un plan combiné doit faire l'objet d'une évaluation combinée.
Une équipe peut étudier la vidéo humaine pour des représentations visuelles ou des tâches et recueillir séparément des démonstrations de robots pour la supervision d'action. La valeur de la combinaison dépend du modèle et de la tâche; elle doit être mesurée à partir d'un niveau de référence explicite.
Choisissez en fonction du signal manquant.
Si l'information manquante est une commande robot associée à une observation, discutez de la téléopération et de l'enregistrement. S'il s'agit de la variété du travail réel, des interactions d'objets ou d'un contexte de tâche plus long, considérez la collection égocentrique. Si les deux sont manquants, séparer les exigences avant d'estimer le volume.
Questions fréquentes
La vidéo égocentrique peut-elle remplacer les données de téléopération ?
Pas lorsque l'objectif d'entraînement nécessite des actions robotisées mesurées que la vidéo ne contient pas. La vidéo humaine et la téléopération peuvent servir différentes parties d'un pipeline d'apprentissage.
La téléopération produit-elle toujours des données prêtes à la formation?
C'est pas vrai. Les observations, les actions, les horodatages, les unités et les limites des épisodes doivent encore être enregistrés et vérifiés. Une méthode d'enregistrement n'est pas une spécification complète de l'ensemble de données.
Quelle méthode une équipe de robotique devrait-elle choisir en premier ?
Choisissez la méthode qui capte le signal manquant de votre expérience actuelle. Définir les entrées du modèle, les actions ciblées ou les étiquettes, et l'évaluation avant de choisir le volume de collecte.
Sources et lectures complémentaires
Sources primaires vérifiées le 26 octobre 2026.